De kracht van een Company Brain
Elke chat begint bij nul, tot je je kennis eenmaal opschrijft. Zo bouwden we het company brain van co-Founded by AI: 55 markdownbestanden in een gedeelde map die elk model leest. De zeven stappen, en wat ze opleveren.
Elke nieuwe chat met AI begint bij nul. Jurriën legt de positionering uit, plakt de prijzen erbij, vertelt wie de doelgroep is en welke toon erbij hoort. Twintig minuten later staat het model scherp en krijgt hij de eerste antwoorden. De week erna opnieuw, in een ander venster, met een ander model, met net iets andere woorden. Tegelijkertijd doet Geert-Jan iets soortgelijks. In zijn AI omgeving, met zijn skills en memory.md.
Wij hielden dat een paar maanden vol. Maar we werkten langs elkaar heen. Daarna bouwden we een company brain: één gedeelde map met platte tekst waar elk model uit leest. Vandaag staan er tientallen documenten en beelden in. Elke AI sessie start daar. Elke AI sessie eindigt daar. Ongeacht of we Claude, Codex, Code of een andere tool gebruiken.
Een map, geen tool
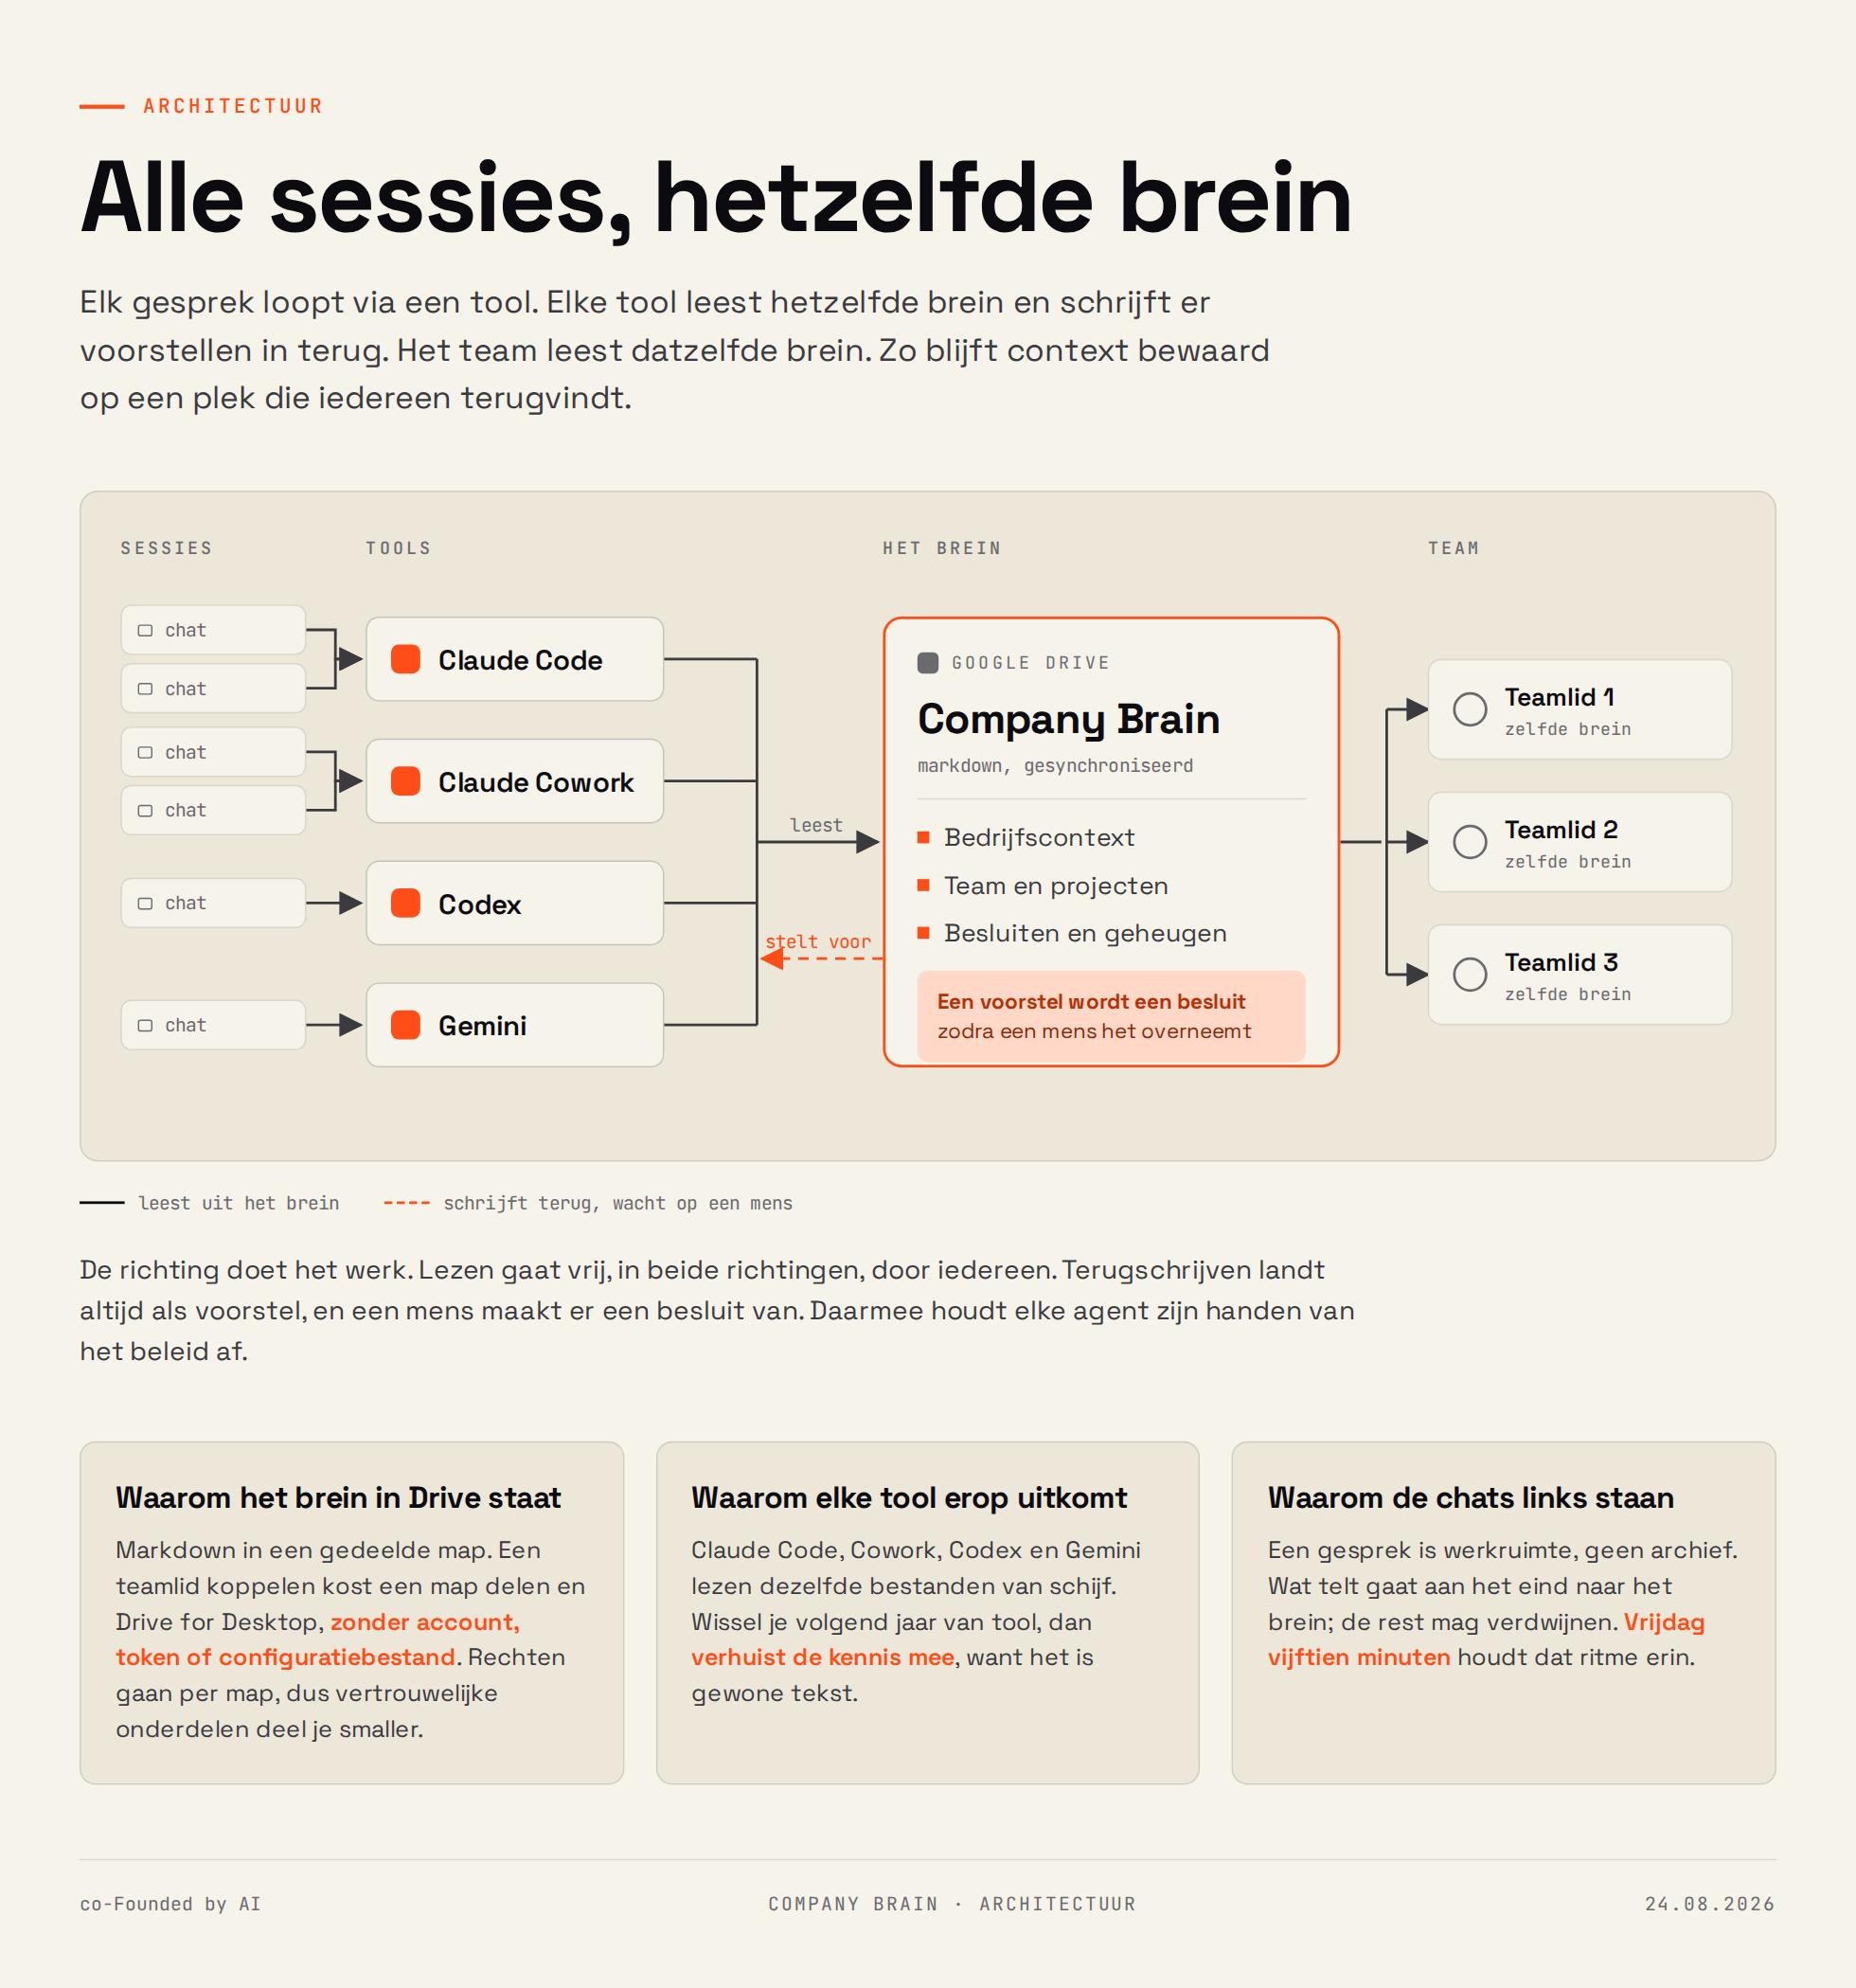
Het brein is een map in Google Drive. Markdown, mappen met nummers ervoor, frontmatter bovenaan elk bestand. Meer zit er niet in.
Die simpelheid is de kracht. Claude Code leest die bestanden van schijf. Claude Cowork ook. Codex en Gemini ook. Er is één versie van de positionering, en die staat op één plek. Stapt iemand volgend jaar over op een ander model, dan verhuist de kennis mee, want tekst leest overal. Moet iemand zich inlezen in ons bedrijf: de brain bevat de waarheid en de afspraken die we samen maken.
De indeling is opzettelijk saai. 00-core bevat wat voor alles geldt: positionering, oprichters, besluiten, leerpunten. 10-cofounded draagt het merk, 20-design de tokens, 30-minagi het product, 40-ambassadors de twee digitale gezichten, 50-media het beeldbeleid, 60-ops de stack en de cijfers, 70-methods de werkwijzen. 90-archive bewaart ruw materiaal en in _inbox staan keuzes die op een besluit wachten. Een nummer voorop houdt de volgorde stabiel in elke verkenner en in elke tool.
Een teamlid aansluiten kost een map delen plus Drive for Desktop. Verder is er niks: account, token en configuratiebestand blijven achterwege. Rechten lopen per map, waardoor je de vertrouwelijke delen anders deelt dan de rest van de informatie.
Wat het oplevert
Drie dingen, en ze versterken elkaar.
Consistentie. De tone-of-voice, de prijzen, de scheidingsregel tussen co-Founded by AI en minagi: elk model hanteert dezelfde versie. Een tegenstrijdigheid valt op, in plaats van dat hij ongemerkt in een LinkedIn-post belandt. Dat is wel een fijn gevoel.
Snelheid. Een sessie begint met lezen en start daarmee op driekwart. De tijd die eerder in context uitleggen zat, zit nu in het werk zelf.
Geheugen. Besluiten en leerpunten zijn vastgelegd, met de reden erbij en met wat ze vervangen. Dat materiaal voedt het weeklog, de column en (in een later stadium) het boek.
Het derde punt verrast het meest. Een bedrijf vergeet zijn eigen redenering sneller dan je denkt. Waarom viel die leverancier af, waarom staat die prijs op dit bedrag, waarom heet het product zo: een half jaar later kent iedereen de uitkomst en niemand de reden. Een besluitenlog dat per regel de reden meeneemt houdt die redenering vast, en levert bovendien een helder verhaal voor naar buiten.
De stappen die wij zetten
1. Kies een plek die synchroniseert
Google Drive, met de map op “offline beschikbaar”. Zonder die instelling staat er een placeholder op schijf waar een agent niks mee kan. Staat de map onder “Gedeeld met mij”, maak er dan een snelkoppeling van naar je eigen Mijn Drive, anders synct Drive for Desktop hem over.
2. Maak één ingang
BRAIN.md is het startpunt. Bovenaan de waarheidsvolgorde, daaronder een routeringstabel: welk soort werk vraagt om welke bestanden. Schrijf je een weeklog, dan laad je 10-cofounded/ plus het besluitenlog. Werk je aan productcopy, dan laad je de minagi-map met de grenzen erbij. Zo leest een model drie bestanden in plaats van vijfenvijftig.
Die tabel bespaart meer dan tijd. Een model dat alles tegelijk inleest verliest scherpte en haalt er de verkeerde alinea uit. Een model dat precies de drie relevante bestanden leest antwoordt met de woorden die je zelf hebt opgeschreven.
3. Leg de waarheidsvolgorde vast
Twee bestanden spreken elkaar ooit tegen. Deze volgorde lost dat op: het besluitenlog wint altijd, daarna de scheidingsregel, daarna het onderwerpbestand, daarna alles daarbuiten. De inbox staat onderaan, onder alles.
Die ene alinea voorkomt de meeste discussies met en over een model.
4. Zet frontmatter bovenaan elk bestand
Zes velden: scope, audience, language, owner, status en updated. scope: cofounded stroomt nooit door naar productcopy. audience: confidential verschijnt nooit in publicatie. status: needs-input betekent vragen stellen.
Zo doet een model aan zelfcensuur op de goede plek, op het juiste moment, zonder dat jij het per opdracht herhaalt.
5. Laat modellen alleen in de inbox schrijven
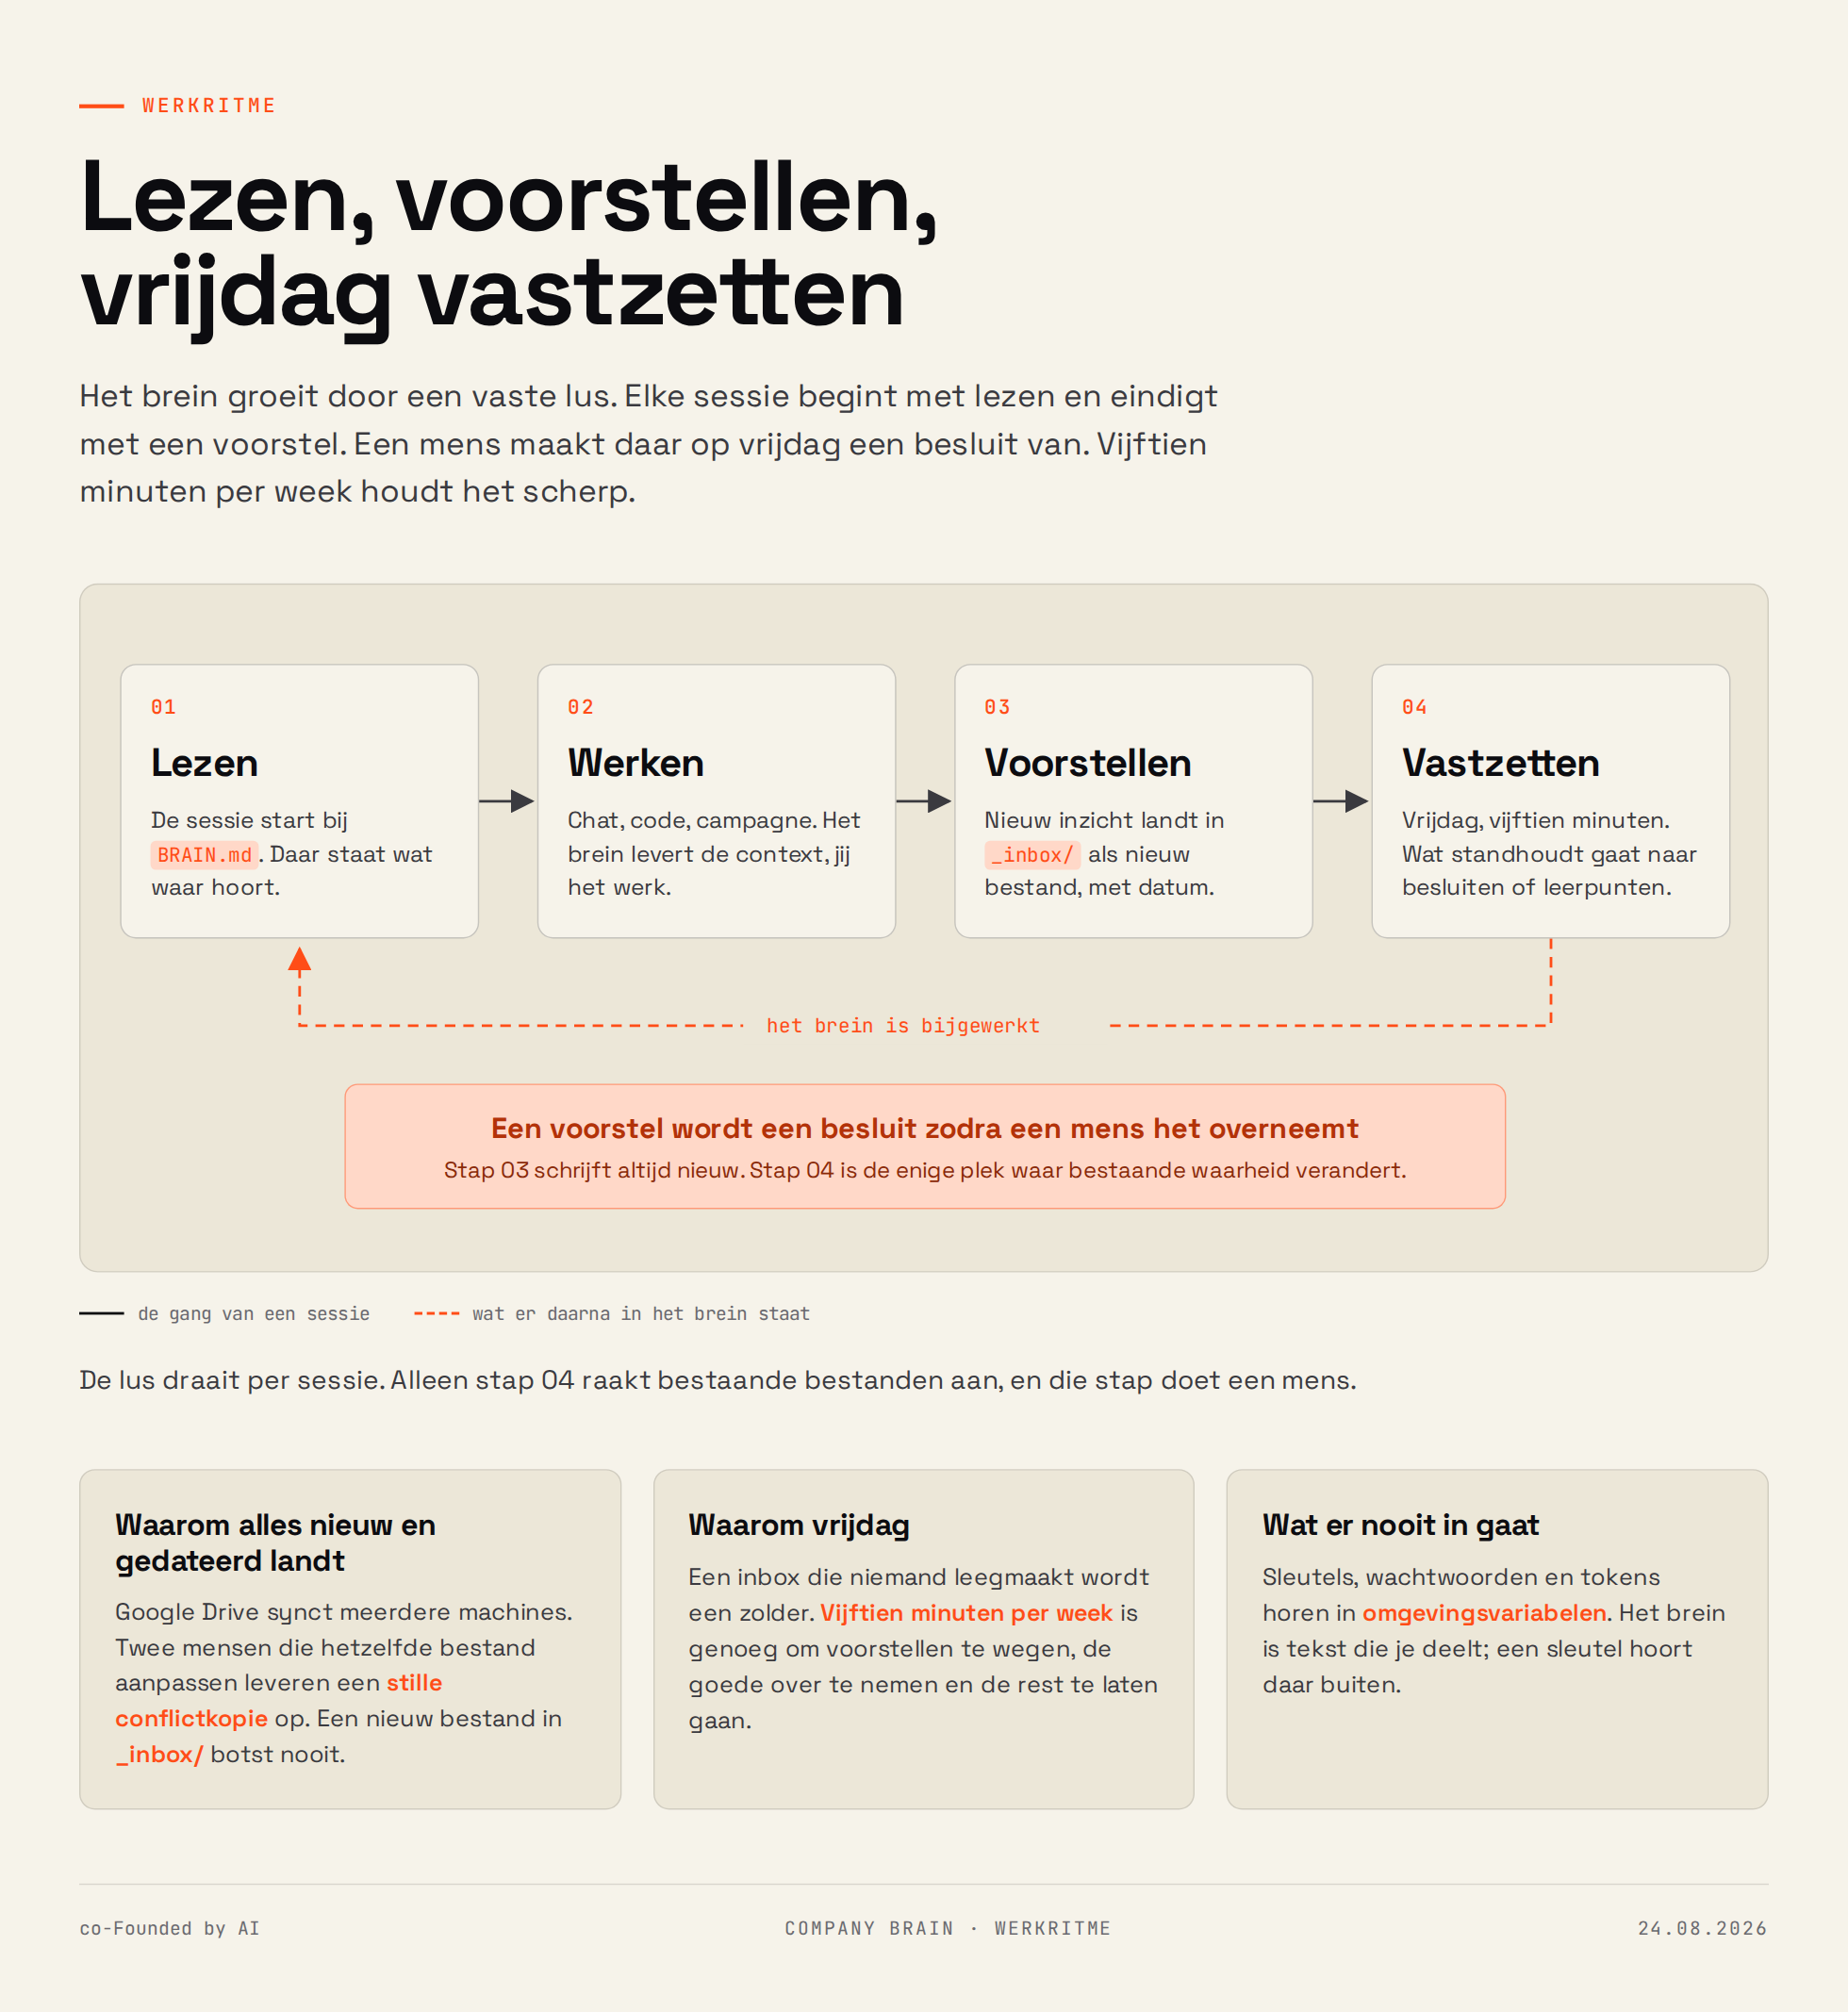
Dit is de belangrijkste regel van allemaal. Alles wat een model concludeert landt als nieuw bestand in _inbox/, met de datum in de naam. Bestaande onderwerpbestanden blijven onaangeroerd.
Twee redenen. De eerste is technisch: Drive meldt een botsing zelden en maakt er stil een tweede versie van, decisions (1).md. Een nieuw bestand per notitie botst nooit. De tweede is inhoudelijk: een suggestie van een model telt pas als besluit nadat een mens hem overneemt. AI adviseert, de mens beslist. Anders schrijft een agent op dinsdag zelfstandig beleid dat op donderdag als waarheid terugkomt.
6. Distilleer op vrijdag, vijftien minuten
De inbox leeglezen. Wat een besluit is naar het besluitenlog, met de reden en met wat het vervangt. Wat een feit is naar het onderwerpbestand. Wat een leerpunt is naar de leerpunten. De rest weg.
Vijftien minuten per week houdt het scherp. Zonder dat ritueel verzandt de brain binnen twee maanden en groeit de inbox uit zijn voegen. Bonus: de besluiten die bovenkomen bevatten precies de content voor het weeklog van die week.
7. Bouw een leespagina
Een map met tientallen markdownbestanden leest prettig voor een model en lastig voor een mens. Daarom staat er een brain.html naast: één pagina die de hele brain toont als een toegankelijke kaart. Klik een ring en de documenten van die map klappen open. Klik een document en de tekst verschijnt rechts, met de frontmatter als labels erboven. Alles te doorzoeken via een krachtige searchfunctie.
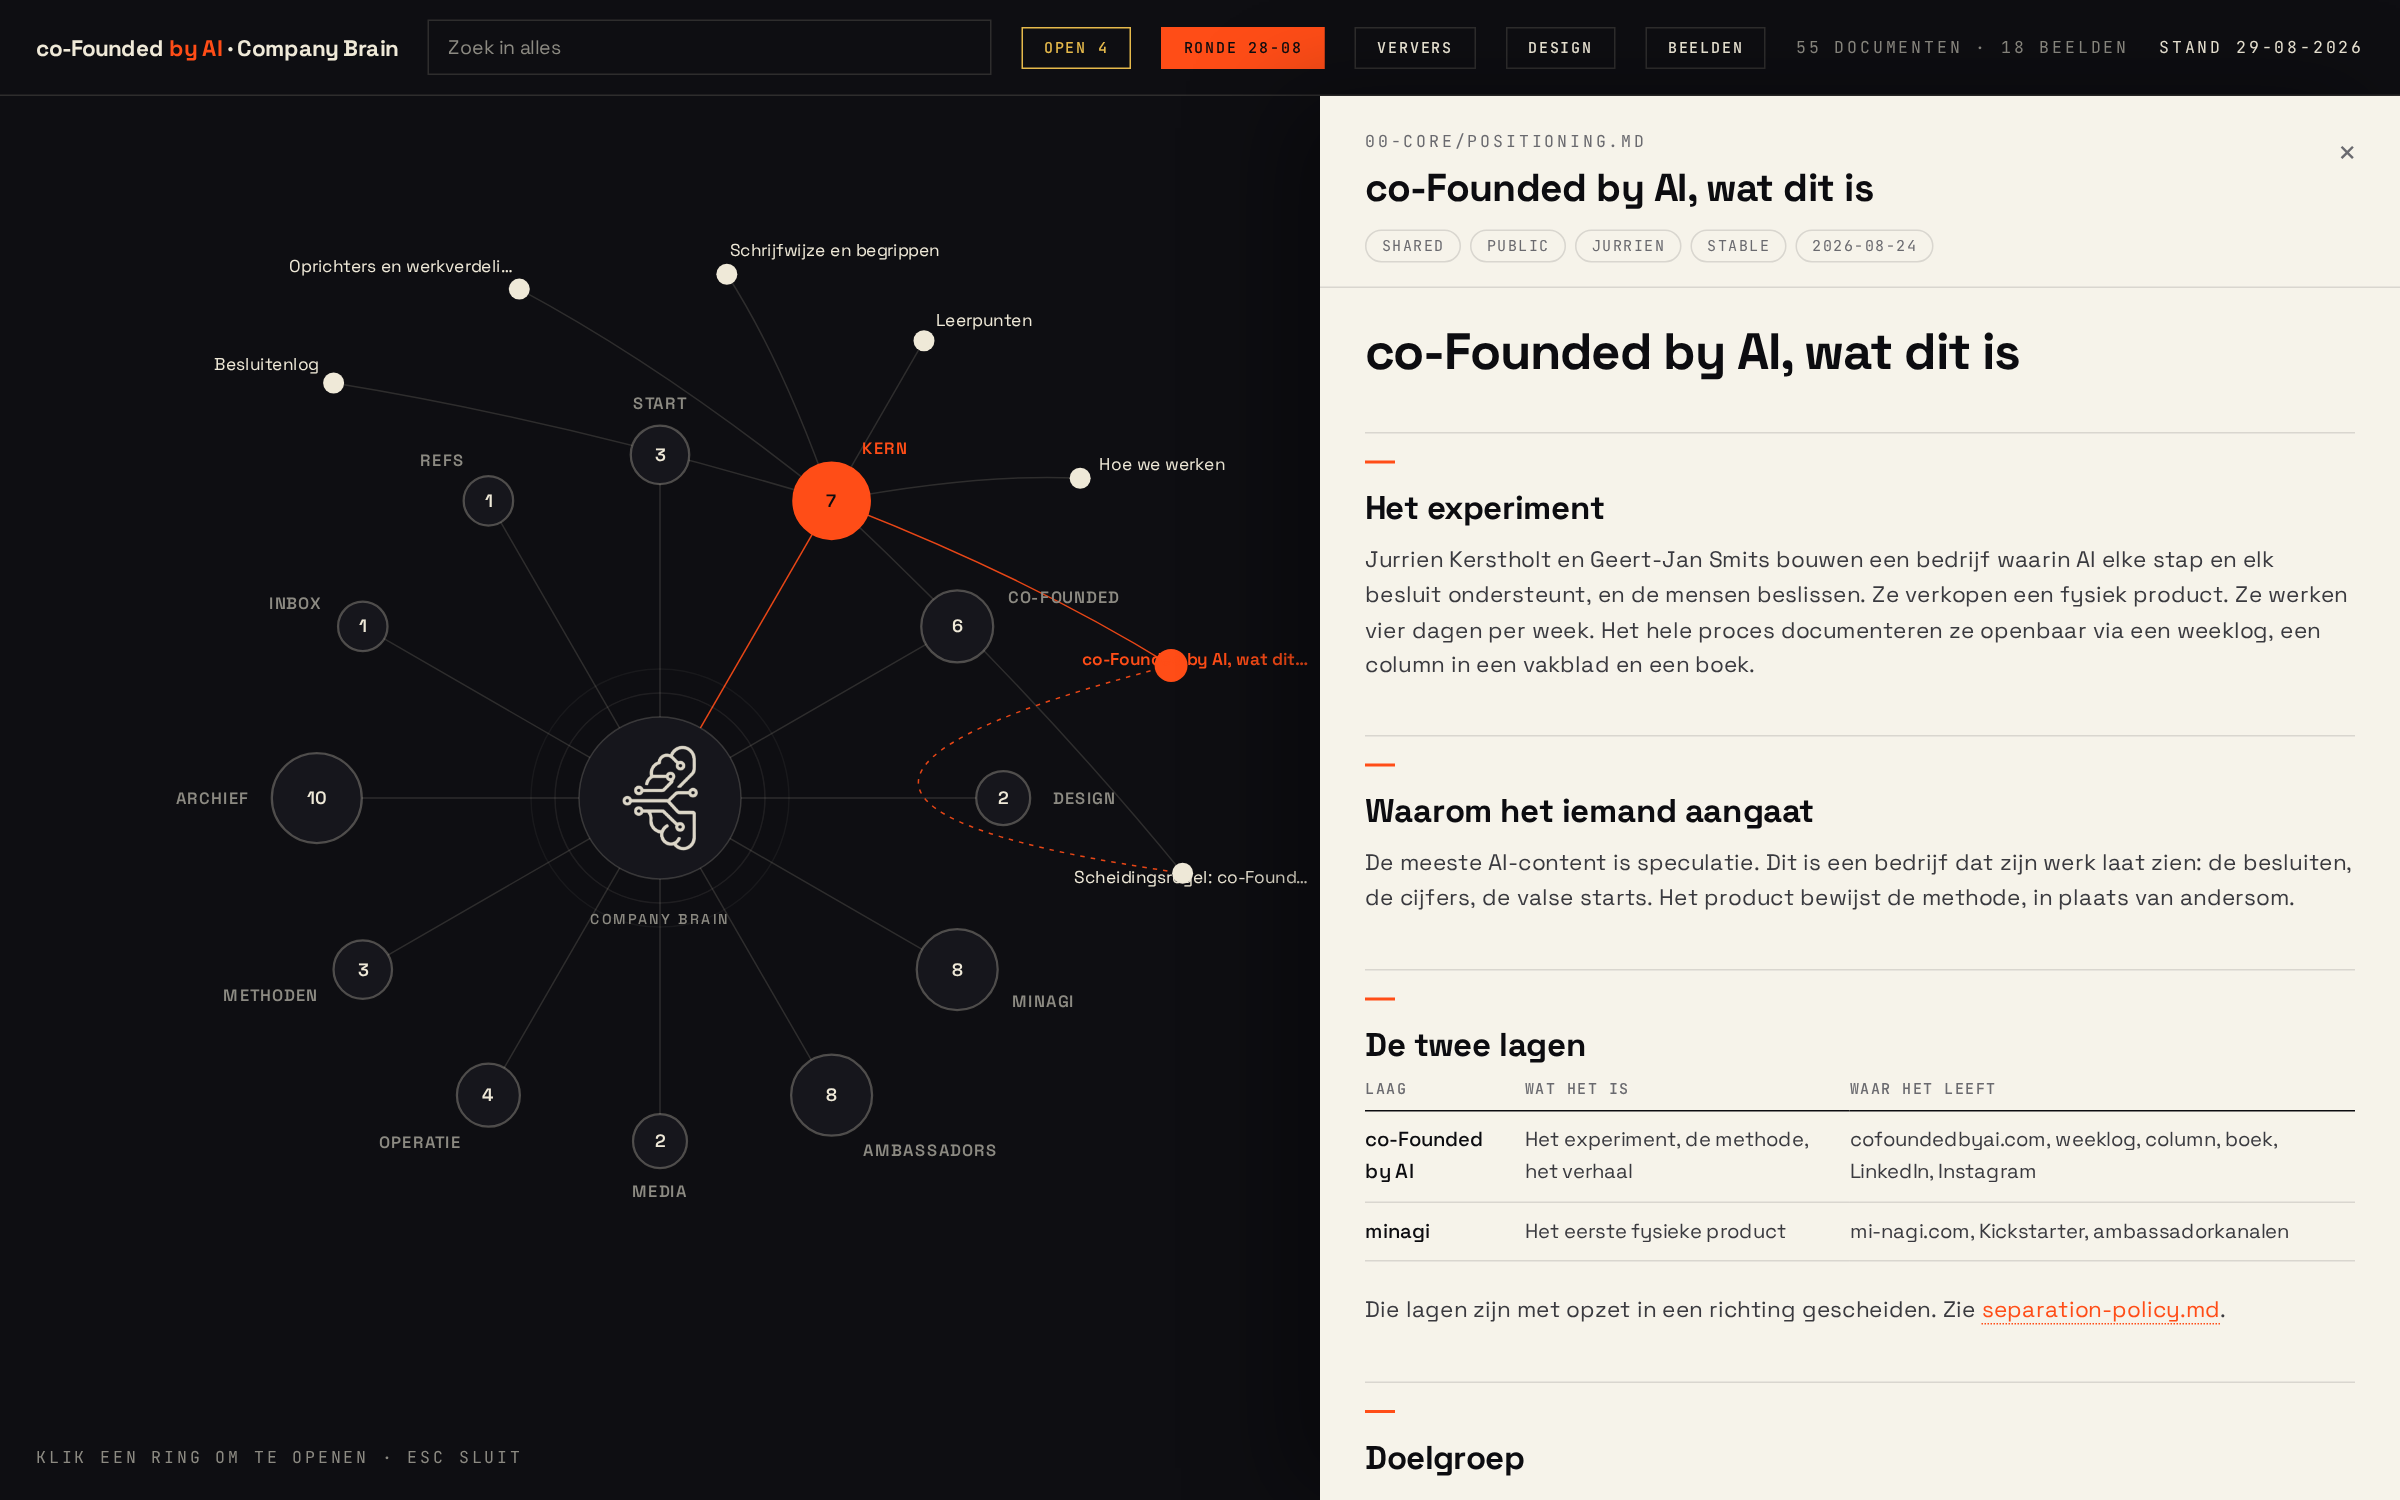
Sinds eind augustus leest die pagina de map zelf uit via de bestandssysteem-API van de browser. Eén keer toestemming geven, daarna ververst hij bij elke keer openen op de achtergrond.
Drie dingen die we leerden
Houd het simpel. Voeg eerst een bestand toe, pas daarna een map. Een structuur die iedereen onthoudt is beter dan een structuur die netjes oogt.
Alles erin opslaan maakt de uitkomst slechter. Ruwe chatlogs van vier modellen leveren tegenstrijdige en verouderde context op, en het model kiest dan de verkeerde versie van je positionering. Het filter zit in de distilleerstap: alleen besluiten, feiten en leerpunten komen in de brain.
Sleutels horen elders. Wachtwoorden en tokens staan in omgevingsvariabelen. De brain is tekst die je deelt, en een sleutel hoort buiten die categorie.
Begin klein
Je hebt geen tientallen documenten nodig om te beginnen. Drie volstaan: wie je bent, voor wie je werkt en hoe je klinkt. Zet ze in een gedeelde map, wijs je AI-tool naar dat pad en schrijf één regel in je instructies: lees eerst deze map.
De rest groeit vanzelf, elke vrijdag een kwartier. Binnen een maand merk je het verschil aan de eerste alinea die een model teruggeeft: die klinkt als jij, zonder dat je erom vraagt.